灵感来源
AOSCC 2026第二天日程,11:15-11:45由河北工大AI创新社创始人所演讲的《当「情怀」成为免费劳动力 高校开源社团如何识别与应对「监管套利」》。
演讲期间,我收到了很多关于他的演讲质量低下,甚至有为AdventureX打广告的嫌疑的相关评论。他自己复盘后发现确实存在很大缺陷。
其实他的开场虽然灾难,但危机公关做得确实非常可以,理论上可以借此遮瑕。
故撰写这篇文章。
听众不是傻逼
是的,这是我看完演讲稿后我的第一个建议。
为减少争议,我使用了腾讯朱雀AI进行检测:
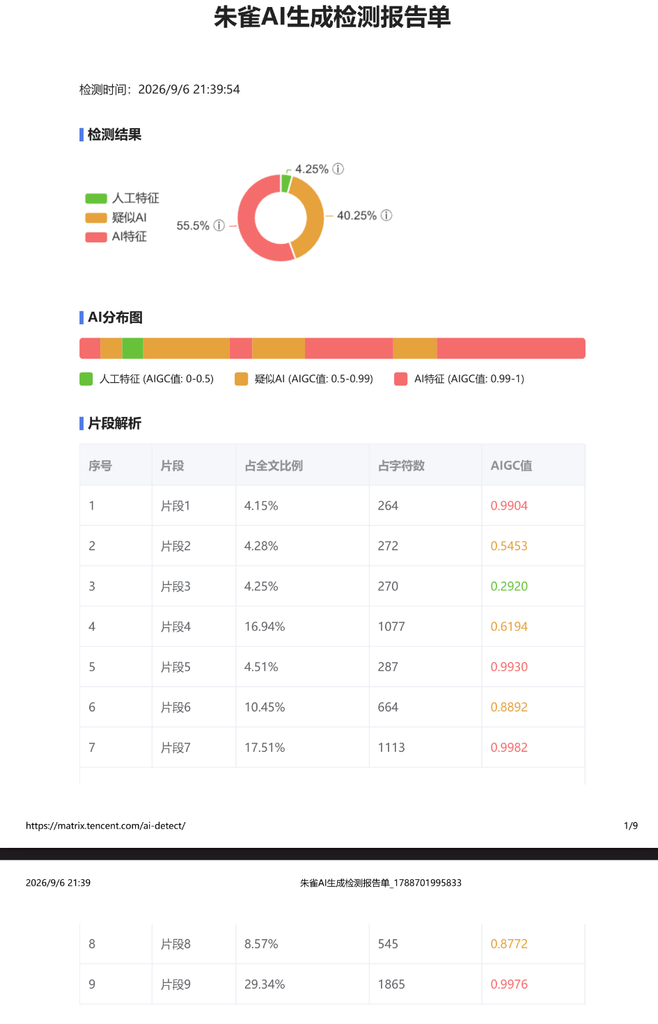
听众不是傻逼,AI的味道他们是能嗅出来的。
例如:
……吗?
先说好——不是。……
——开场白
如果你的演讲稿是AI出来,没有经过个人修改的,那就有了一个小问题,你和AI有什么区别?你只是AI的转述者吗?
我为什么不直接找deepseek,甚至豆包?
可以提及,不要过分
在演讲稿中,我们可以提及AdventureX,但是不要把文章主体都写成对AdventureX的广告。例如,在该演讲稿中,我发现至少在4个章节都提及了它,而整个演讲稿只有8个章节。
过于分散的提及很容易给人带来一种印象:整篇文章都是为了这碟饺子醋包的饺子。
当然,无关紧要的也尽量不要提及太多,容易喧宾夺主。
上台前好歹串一遍
这个是为了了解自己写的什么东西,以及应该使用什么声调(有些地方没有必要非得用不熟悉的方言讲述)。如果你是AI写稿,请务必串至少三遍,思考哪里还能改善。
原演讲中,该讲者讲的磕磕绊绊,很明显是AI写稿自己还没读的。
我的实践是什么样的
底线
先说明底线:AI能用,只能在不重要的部分用,例如PPT。演讲稿必须完全由自己撰写。
工作流
我一般是先写好演讲稿,再去做PPT。演讲稿定大致方向,PPT用于让注意力不太集中的听众迅速找回状态。
以我论文为例:
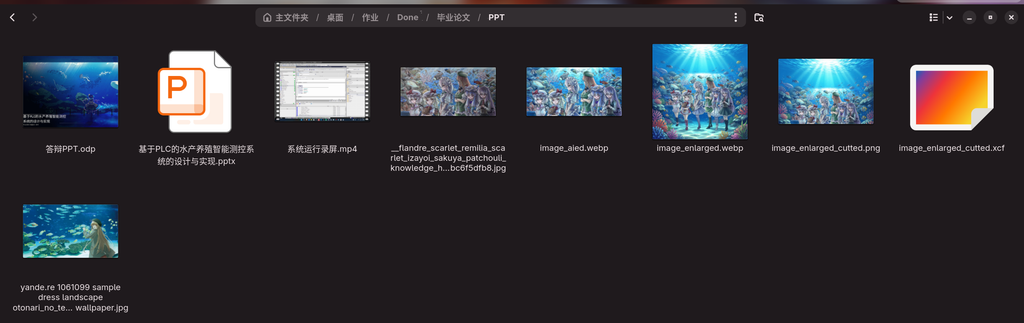
这个是实在没时间了,让AI写了一个。没有演讲稿的原因是实在没时间,所以内容全在PPT里,读PPT就是。
即使这样,也有一些约定俗成的规则:
- 绪论:这个大家看一看就好。
- 总体设计实现:读PPT,因为足够全面
- 展望:这个夹了私货。众所周不知,我毕设做的是PLC,里面展望把OPC UA定义为了改进方向,所以私货就是黑板画图对比MQTT和OPC UA的区别,和如果用上了MQTT,架构会是什么样
再以我课程作业为例:
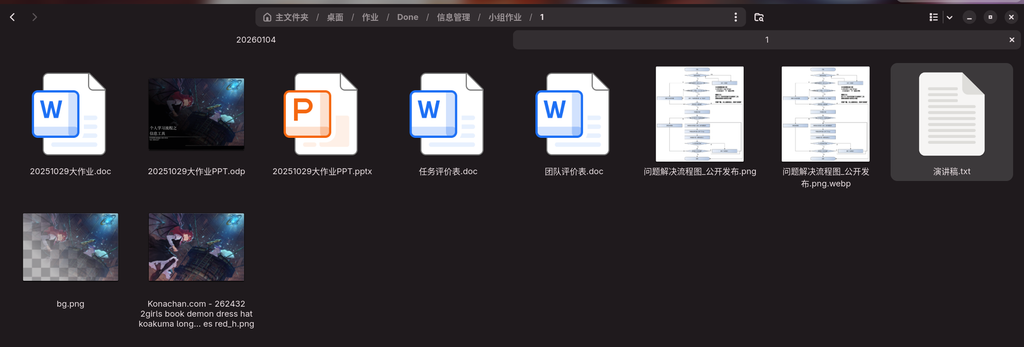
如下是我的演讲稿:
Page #1
[Introduction]Page #2
如上是我们的分工。Page #3 – Preface
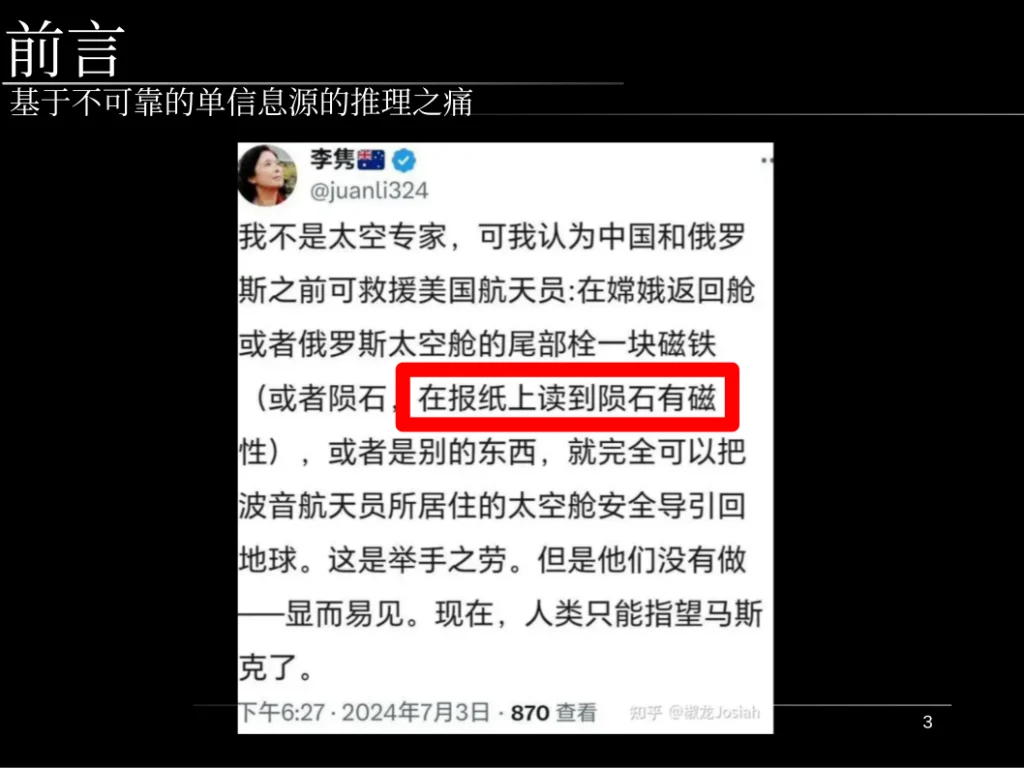
在现代社会,传统学习方法已无法满足社会需要,如图中提到的李隽。我们可以注意到其说明其信源仅有报纸,而很明显基于单信源的推理远不足以满足需求。
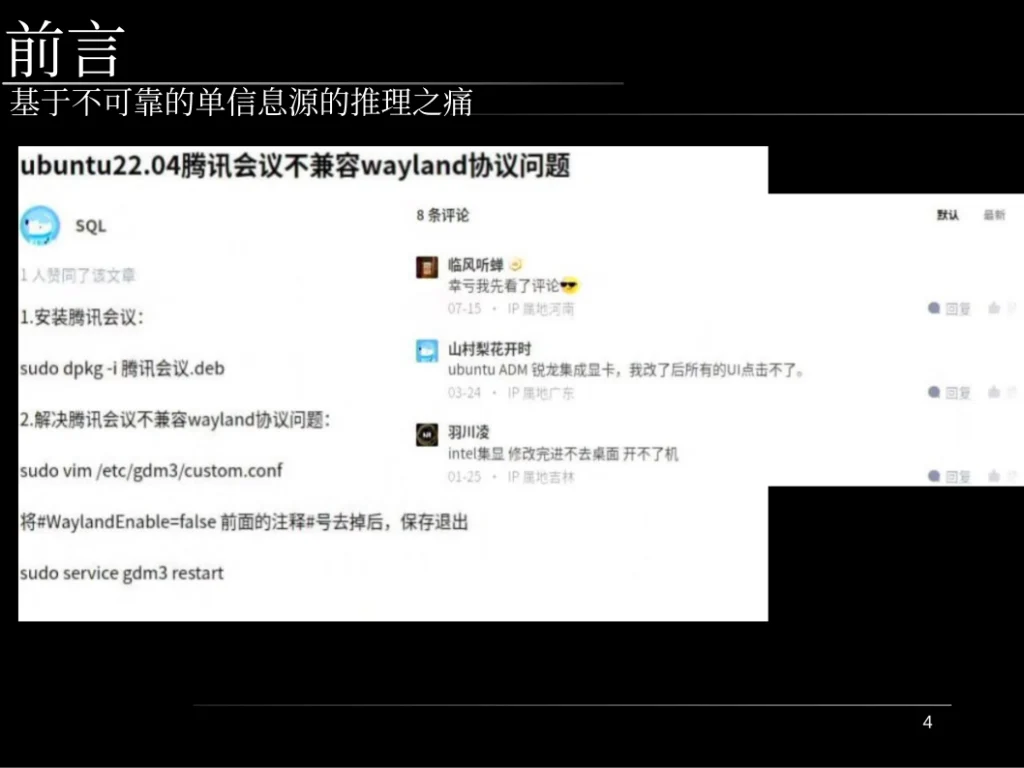
如果这个案例还不太明显的话,我有个更垂直的案例。Page #4
鉴于大多数人对这几行命令和背后的整个Linux图形栈并无任何概念,简单说就是,一个图形服务器协议被禁用了,因其被桌面环境等设施依赖,造成基于其上的设施也炸了,而且症状也各不相同,有GNOME桌面环境炸的,有进不了登录界面的,总之很乱。
所以我们需要结合其它资料进行分析总结。Page #5 – Section #1
目前信息检索有两种方法:
- 搜索引擎
- LLM
需要注意的是,大语言模型的搜索渠道其实也是搜索引擎,它只是帮你完成了总结和实践。
Page #6 – Section #1.1.1
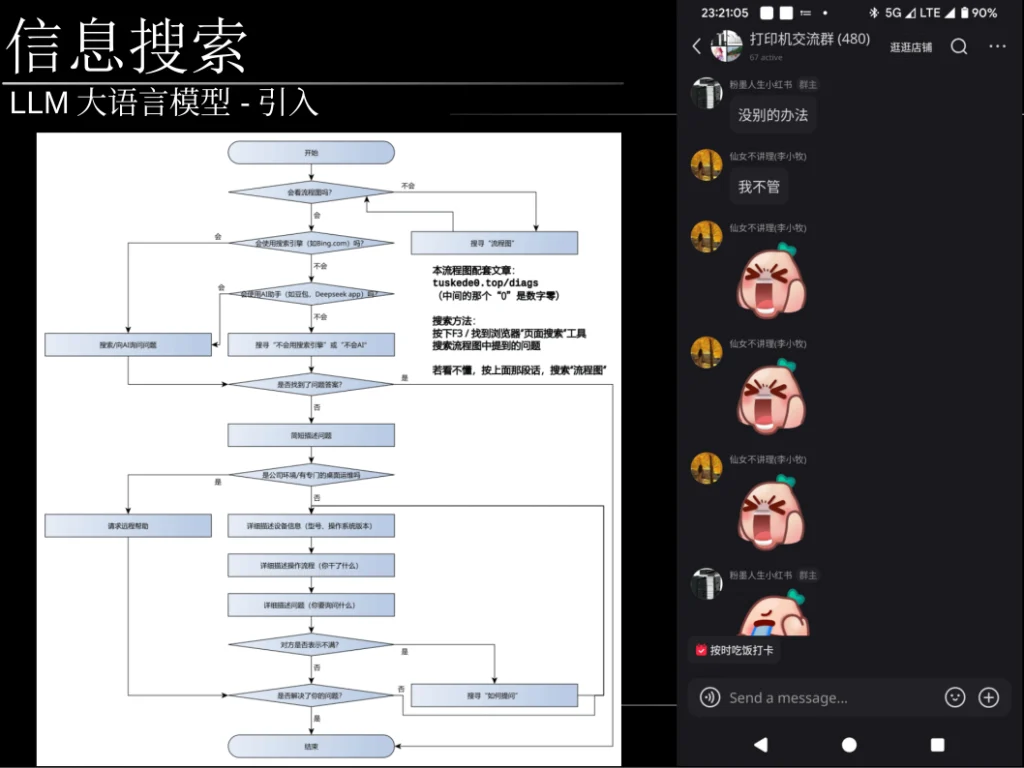
在很久之前,我们组中有人曾制作过类似流程图和配套文章:《对非专业用户的通用问题诊断指南》。我们可以借用他的文章与流程图。它出现的背景是知乎答主“粉墨人生”多次在小红书群遇到随意大小叫死活不去解决问题的用户,同时在部分社区也出现了类似状况。
鉴于这类用户使用搜索引擎可能有些困难,我们可以用大语言模型作为第一个分流途径。Page #7 – Section #1.1.3
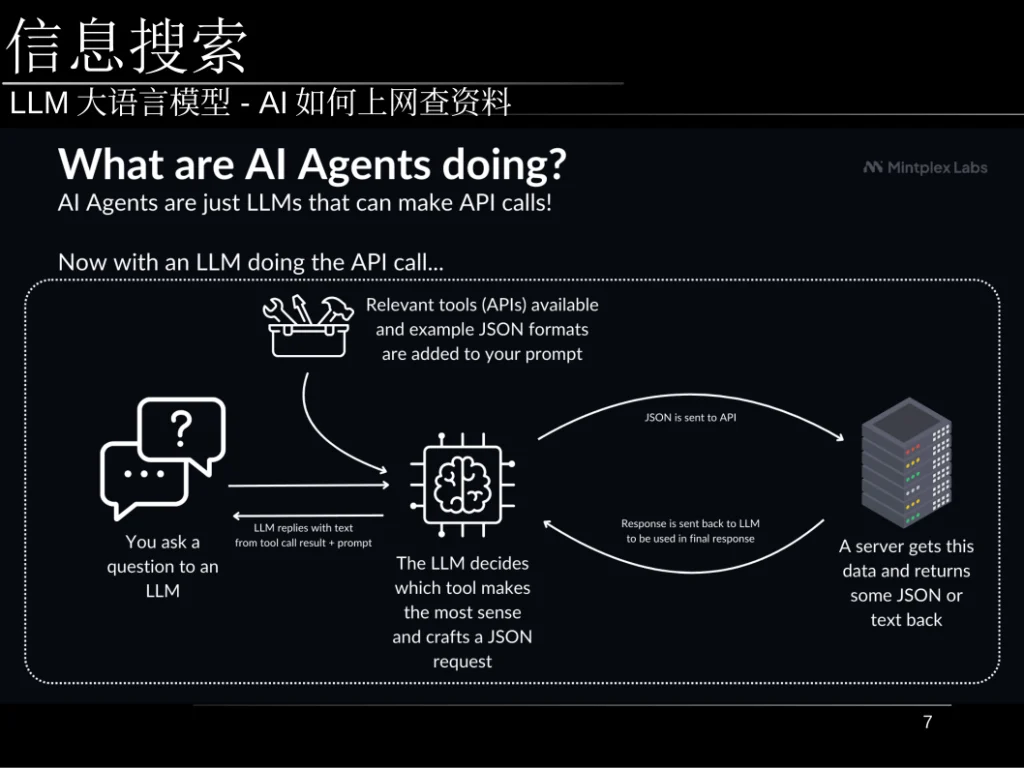
关于AI上网查资料这档子事,如图,简单说就是AI思考后会生成一个JSON文件,并由客户端与搜索引擎进行交互,获取到结果之后AI会生成回答。例如这个图片是AnythingLLM的,处理智能体这个也是AnythingLLM去做的,单独的一个ollama或llama.cpp无法实现联网。
Page #8 – Section #1.2
由上文所述,终究还是需要搜索引擎。
搜索引擎有几个部分,爬虫,数据库,网页。爬虫用于采集信息,数据库用于整理、输出信息给前端,前端页面用于向用户展示信息。Page #9 – Section #2
仅搜索引擎并不可靠。
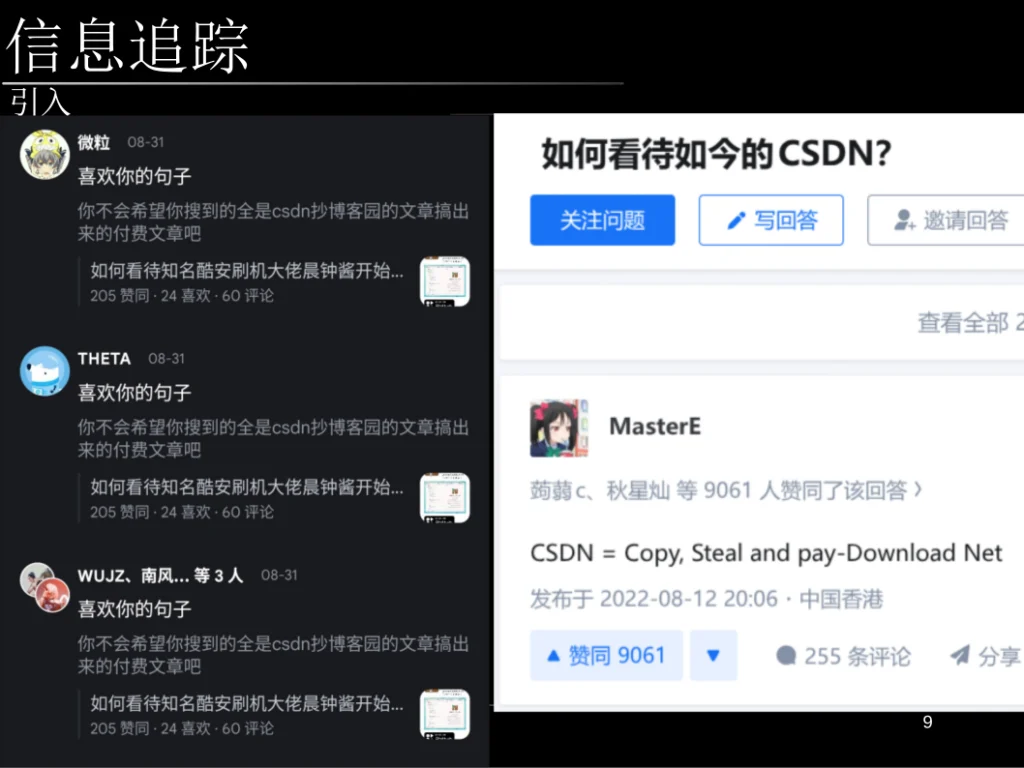
先不说比较古早的魏则西事件了,现在有了一种不需要塞钱就可以“欺骗”搜索引擎把垃圾内容放前面的手段,叫SEO,搜索引擎优化。CSDN就是一个例子。
所以,不需要靠搜索引擎喂饭的订阅出现了。Page #10 – Section #2.1
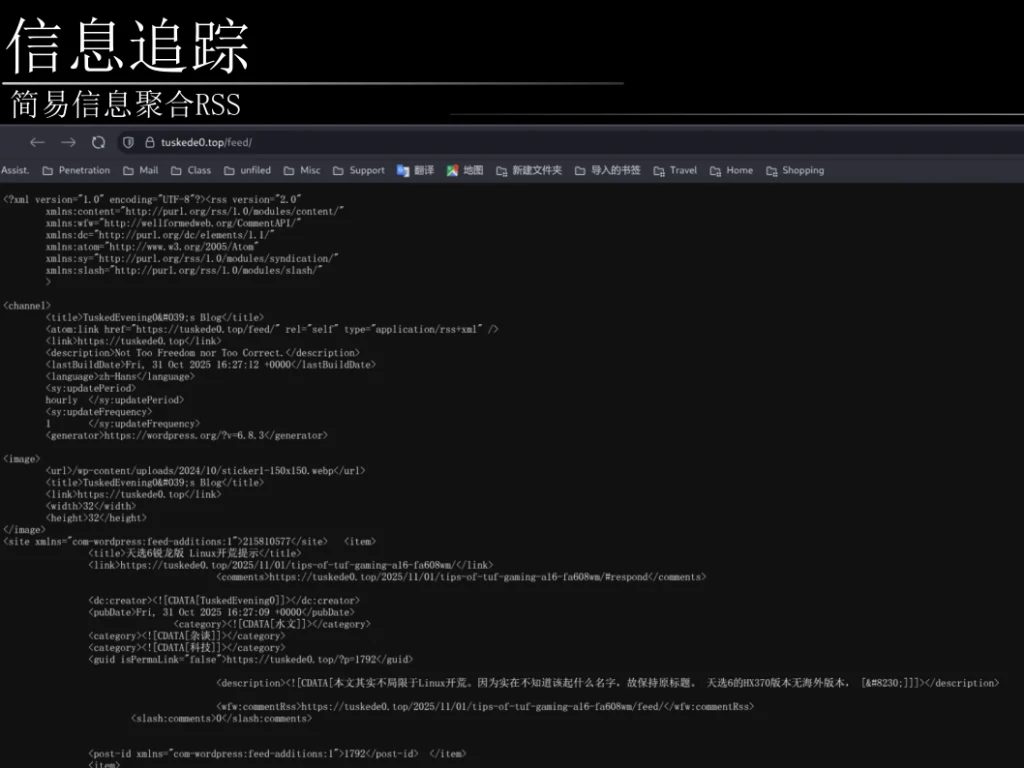
如图,RSS是一种基于XML格式的标准化内容分发协议。图里展现出的是原始内容,经过RSS客户端解析后会变得更友好一些。
Page #11
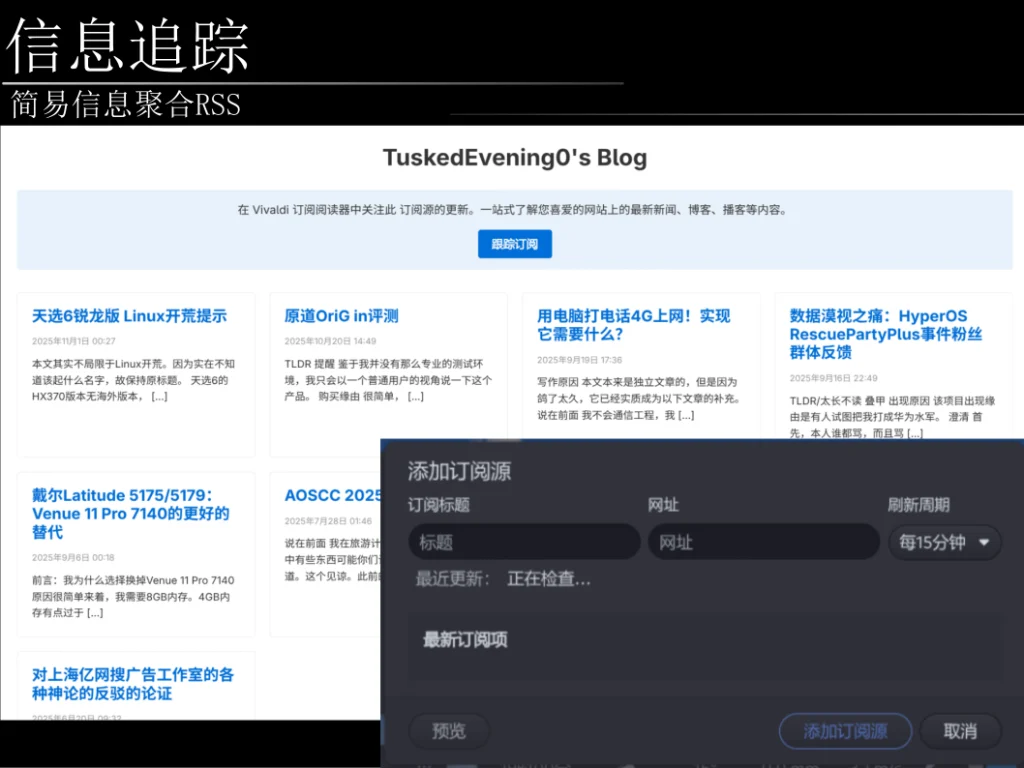
嗯,类似于这样。这个界面是Vivaldi浏览器渲染的。
当然你可以从下面这个截图里注意到,RSS并不是主动喂给你的形式,而是类似于报刊订阅:你找邮局定了份报纸,邮局把这报纸给你送到家。这就是订阅,也是RSS的基本原理。
至于它有什么意义,源并不控制内容展示的优先级,这种东西一切由你决定。Page #12 – Section #3
从这里就没有PPT了,直接上实例。信息管理、加工与输出可以为一条链路,而且这种串联发展到现在已经非常成熟。
[ctf.xatu.edu.cn:REDACTED]如例。这个网站使用了WordPress。WordPress是一个内容管理系统(CMS),它可以在同一个地点做到信息管理、加工与输出。
鉴于这个站点我只参与优化,我将会用我个人博客进行后续举例。[tuskede0.top]WordPress的搭建可以使用传统方案,也可以使用容器。目前推荐Docker,因为部署只需要docker compose up -d,特别简单。
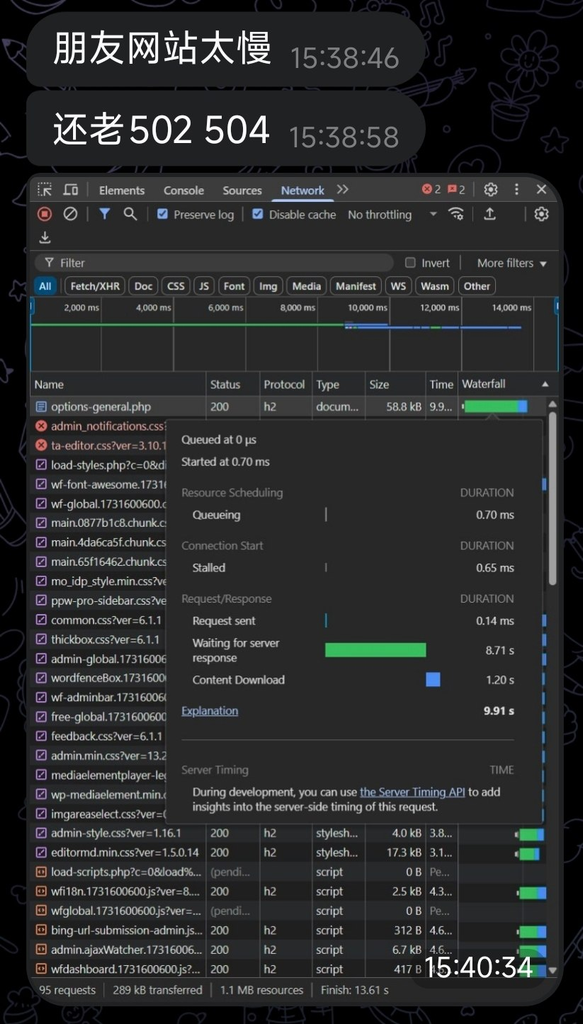
但是我是不推荐使用WordPress的,因为[Telegram-MBRjun:朋友网站太慢]大部分人只会一味插件塞爆,优化什么的根本不会去做。而且它要维护的东西比较多。当然,你还可以把这三个步骤拆开,这就得提到静态页面生成器了。信息输出成本非常低,而且天然云原生。[github.com/mbrjun/mbrjun-blog]通过选择性的“编译”内容,也能实现和CMS类似的效果。
这个是正经的,自己花时间去写的,好歹真的是人类思考而成的。可惜当时小组里疑似内战,没被采用。
我虽然提及了WordPress,但很明显我是分了两部分说的,没有完全推荐。而实际上,CMS不止有WordPress,这个也是众所周知的。

发表回复